
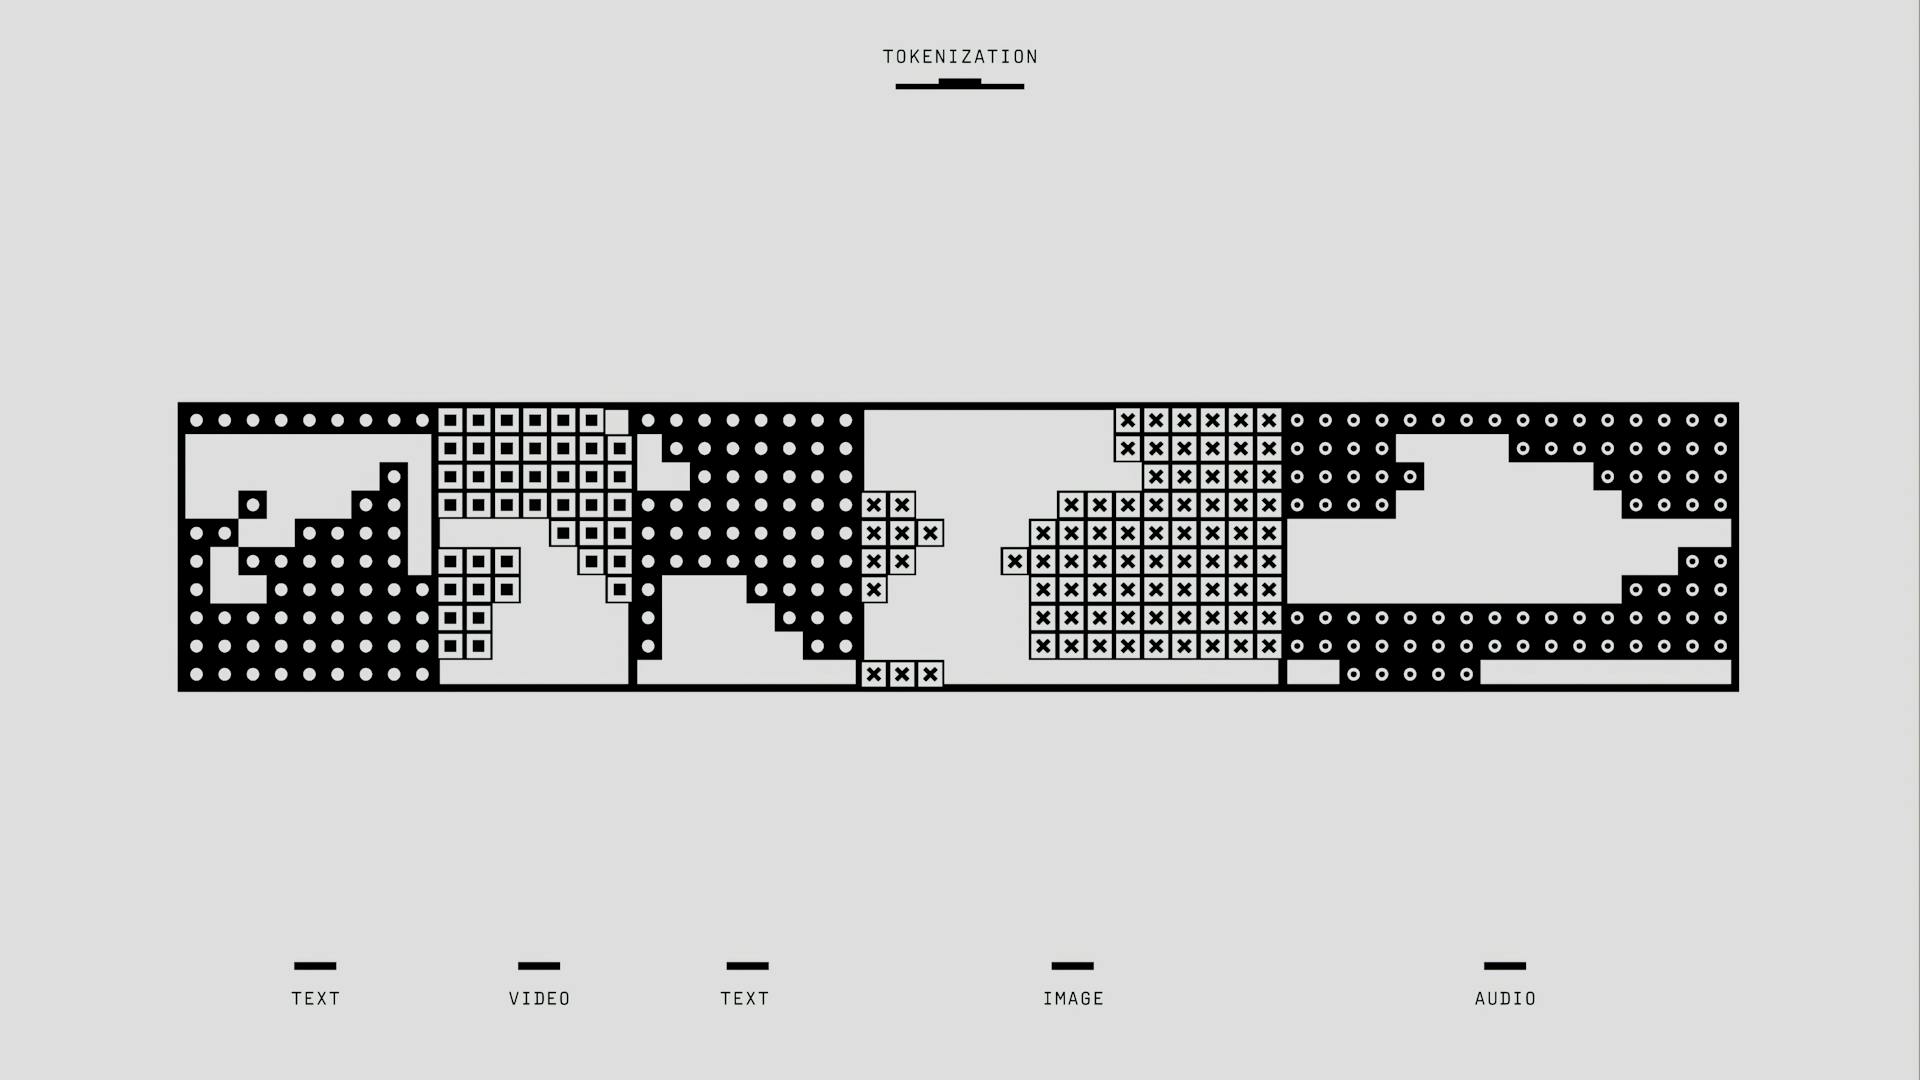
In der Künstlichen Intelligenz (KI), und besonders bei großen Sprachmodellen (LLMs), sind Token die Grundeinheiten der Sprache, mit denen Maschinen Text verstehen und menschenähnlichen Text erzeugen können. Dieser Artikel erklärt, was Token sind, woher sie kommen, welche Arten es gibt und welche Bedeutung sie für die KI haben.
Was sind Token?
In der KI ist ein Token eine einzelne Texteinheit, etwa ein Wort, ein Zeichen oder ein Wortteil, und damit der Grundbaustein der Sprache. LLMs verarbeiten, analysieren und erzeugen Text in diesen kleinsten Einheiten. Stellen Sie sich Token als die LEGO-Steine der Sprache vor: Jeder Stein (Token) lässt sich mit anderen zu sinnvollen Strukturen (Sätzen, Absätzen und so weiter) zusammensetzen.
Wozu gibt es Token?
Token geben Maschinen eine Möglichkeit, menschliche Sprache darzustellen und zu verarbeiten. Menschliche Sprache ist komplex und nuanciert: Wörter, Wendungen und Sätze transportieren Bedeutung und Kontext. Token vereinfachen diese Komplexität, indem sie die Sprache in kleinere, handhabbare Einheiten zerlegen, die Maschinen verarbeiten und analysieren können.
Eine kurze Geschichte der Token
Das Konzept der Token reicht bis in die Anfänge der Informatik zurück, als Forschende nach Wegen suchten, menschliche Sprache darzustellen und zu verarbeiten. Einer der frühesten Tokenisierungsalgorithmen entstand in den 1950er-Jahren und stammt vom Linguisten und Informatiker Noam Chomsky. Sein Algorithmus, bekannt als „Chomsky-Normalform“, diente dazu, die Struktur von Sätzen zu parsen und zu analysieren.
In den 1980er-Jahren revolutionierte die Entwicklung des „Bag-of-Words“-Modells die Verarbeitung natürlicher Sprache (NLP). Dieses Modell stellte Text als Sammlung einzelner Wörter dar, ohne deren Reihenfolge oder Kontext zu berücksichtigen. Es kam in frühen NLP-Anwendungen breit zum Einsatz, etwa bei der Textklassifikation und der Informationssuche.
Moderne Tokenisierung
In den letzten Jahren haben Deep Learning und große Sprachmodelle zu ausgefeilteren Tokenisierungsalgorithmen geführt. Einer der beliebtesten ist der „WordPiece“-Algorithmus, den Google 2016 entwickelt hat. WordPiece stellt Text als Folge von Subword-Token dar, also von kleineren Texteinheiten, die aus Wörtern abgeleitet sind.
Arten von Token
Es gibt mehrere Arten von Token, jede mit eigenen Merkmalen und Einsatzgebieten:
- Wort-Token: Sie stehen für einzelne Wörter eines Satzes. Im Satz „The quick brown fox jumps over the lazy dog“ ist zum Beispiel jedes Wort ein eigenes Token.
- Zeichen-Token: Sie stehen für einzelne Zeichen, also Buchstaben, Ziffern oder Sonderzeichen. Man setzt sie oft bei Aufgaben wie der Sprachmodellierung ein, bei der das Modell das nächste Zeichen einer Folge vorhersagen muss.
- Subword-Token: Das sind kleinere Texteinheiten, die aus Wörtern abgeleitet sind. Sie kommen oft bei Sprachen mit komplexer Morphologie zum Einsatz, etwa Deutsch oder Russisch. Das Wort „unbreakable“ lässt sich zum Beispiel in die Subword-Token „un“, „break“ und „able“ zerlegen.
- Byte-Pair-Encoding-Token (BPE-Token): BPE ist ein Tokenisierungsalgorithmus, der Text als Folge von Subword-Token darstellt. BPE-Token sind in LLMs verbreitet, weil sie einen guten Mittelweg zwischen der Darstellung auf Wortebene und der auf Zeichenebene bieten.
Beispiel für die Tokenisierung
Nehmen Sie den Text: „The quick brown fox jumps over the lazy dog.“ Der WordPiece-Algorithmus zerlegt ihn in diese Token:
•“The“ (1 Token)
•“quick“ (1 Token)
•“brown“ (1 Token)
•“fox“ (1 Token)
•“jumps“ (1 Token)
•“over“ (1 Token)
•“the“ (1 Token)
•“lazy“ (1 Token)
•“dog“ (1 Token)
Dieser Text besteht aus 9 Token, von denen jedes für ein einzelnes Wort des Satzes steht.
Warum die Nutzung und die Kosten von LLMs in Token gemessen werden
Unternehmen rechnen vor allem deshalb nach Token ab, weil sie ein skalierbares, vorhersehbares und effizientes Preismodell brauchen, das zur Nutzung der Rechenressourcen bei Diensten wie großen Sprachmodellen (LLMs) passt. Das sind die wichtigsten Gründe für die Verbreitung tokenbasierter Preise:
1. Die Preise bilden die Rechenkosten ab
Ressourcenzuteilung: Wie viel Rechenaufwand eine Anfrage an ein LLM verursacht, hängt direkt von der Zahl der beteiligten Token ab. Jedes Token braucht Rechenressourcen, und die Abrechnung nach Token erlaubt es Unternehmen, ihre Preise am tatsächlichen Ressourcenverbrauch auszurichten. Aufgaben, die mehr Token brauchen und damit rechenintensiver sind, kosten die Nutzer also naturgemäß mehr.
Vorhersehbarkeit: Mit Token können Unternehmen eine klare und vorhersehbare Preisstruktur anbieten. Nutzer können die Kosten anhand ihrer erwarteten Nutzung abschätzen, was die Budgetplanung erleichtert. Das hilft besonders dort, wo die Nutzung unterschiedlich hoch ausfallen kann, etwa bei API-Aufrufen oder Interaktionen mit dem Modell.
2. Flexibilität und Skalierbarkeit
Anpassbar an verschiedene Anwendungsfälle: Tokenbasierte Preise decken ein breites Spektrum an Anwendungen und Nutzerbedürfnissen ab. Verschiedene Aufgaben (etwa Textgenerierung oder Zusammenfassung) verbrauchen zum Beispiel unterschiedlich viele Token, und mit einem Token-System können Unternehmen die Preise an die Anforderungen der jeweiligen Aufgabe anpassen.
Skalierbares Modell: Wenn Unternehmen wachsen und ihre Nutzerbasis größer wird, skalieren tokenbasierte Preise mit. Nutzer können Token in großen Mengen kaufen oder Tarife abschließen, die zu ihrem Nutzungsverhalten passen. So bedienen Unternehmen kleine Entwickler und große Konzerne gleichermaßen effizient.
3. Einfachere Abrechnung und Nutzungsverwaltung
Standardisierte Leistungen: Die Tokenisierung standardisiert den Verbrauch von Diensten, und das erleichtert Unternehmen die Abrechnung. Wie bei Prepaid-Handytarifen kaufen Nutzer eine bestimmte Menge Token, die sie nach und nach verbrauchen. Das vereinfacht den Kaufvorgang und senkt den Verwaltungsaufwand.
Kontrolle über die Kosten: Nutzer können ihren Token-Verbrauch verfolgen und ihre Ausgaben besser steuern. Diese Transparenz hilft, unerwartete Kosten zu vermeiden, weil Nutzer sehen, wie viele Token sie verbraucht haben und wie viele noch übrig sind.
4. Anreiz zur sparsamen Nutzung
Anreiz zur Optimierung: Mit der Abrechnung pro Token geben Unternehmen ihren Nutzern einen Anreiz, die Interaktion mit dem Modell zu optimieren. Nutzer formulieren ihre Anfragen vielleicht präziser, um weniger zu verbrauchen, und nutzen den Dienst so insgesamt effizienter.
Fokus auf den Nutzen: Tokenbasierte Preise erlauben es Unternehmen, sich auf den Nutzen für die Nutzer zu konzentrieren statt auf die zugrunde liegende Rechenkomplexität. Für Kunden kann das attraktiver sein, denn sie interessieren sich meist mehr für die Ergebnisse ihrer Interaktionen als für die technischen Details, wie diese Ergebnisse zustande kommen.
Zusammengefasst bietet die Abrechnung nach Token einen strukturierten, vorhersehbaren und skalierbaren Preisansatz, der sich eng am Verbrauch von Rechenressourcen durch die verschiedenen Aufgaben in LLMs orientiert. Davon haben Unternehmen und Nutzer gleichermaßen etwas: Die Abrechnung wird einfacher, die Nutzung effizienter, und das Dienstangebot bleibt flexibel.
Die Schwierigkeiten tokenbasierter Preise
Kunden stoßen bei der tokenbasierten Abrechnung von LLMs auf mehrere Schwierigkeiten, die ihnen die Nutzung erschweren und ihre Zufriedenheit mit dem Dienst insgesamt beeinträchtigen können. Das sind die wichtigsten:
1. Schwer durchschaubare Preise
Unklarer Token-Verbrauch: Für Kunden ist oft schwer zu erkennen, wie viele Token ihre Eingaben verbrauchen, denn die Tokenisierung kann sich zwischen Modellen und Anbietern deutlich unterscheiden. Wer den Vorgang und seine Auswirkung auf die Nutzung nicht kennt, muss dann möglicherweise mit unerwarteten Kosten rechnen.
Kostenschätzung: Die Ausgaben anhand des Token-Verbrauchs vorherzusagen, kann schwierig sein. Ohne ein klares Verständnis davon, wie sich Token in Kosten umrechnen lassen, fällt es Kunden schwer, ihre Nutzung sauber zu budgetieren, und sie geben womöglich zu viel aus.
2. Unterschiedliche Tokenisierungsverfahren
Uneinheitliche Token-Definitionen: LLM-Anbieter können unterschiedliche Tokenisierungsverfahren einsetzen, sodass derselbe Eingabetext unterschiedlich viele Token ergibt. Das erschwert den Vergleich zwischen Diensten und kann für Verwirrung darüber sorgen, welcher Anbieter das beste Preis-Leistungs-Verhältnis hat.
Auswirkung auf die Leistung: Die Tokenisierungsstrategie kann beeinflussen, wie gut ein Modell arbeitet. Wer diese Unterschiede nicht kennt, wählt womöglich unbeabsichtigt ein Modell, das nicht zum eigenen Bedarf passt, und das schlägt sich in der Qualität der Ergebnisse nieder.
3. Budget und Finanzplanung
Unvorhersehbare Kosten: Schwankungen im Token-Verbrauch können zu unvorhersehbaren Rechnungen führen und Unternehmen die Budgetverwaltung erschweren. Steigt die Nutzung unerwartet stark an, können die Kosten schnell klettern und die finanziellen Mittel belasten.
4. Begrenzte Eingabegröße
Token-Limits: LLMs haben Obergrenzen für die Token in Ein- und Ausgaben, die beschränken, wie viel Text sie auf einmal verarbeiten können. Diese Grenze (das sogenannte Kontextfenster) kann Nutzer behindern, die mit großen Dokumenten oder komplexen Anfragen arbeiten, denn wichtige Kontextinformationen können verloren gehen, wenn sie das Token-Limit überschreiten.
Abgeschnittene Eingaben: Überschreitet eine Eingabe das Token-Limit, wird sie möglicherweise abgeschnitten. Dann verarbeitet das Modell sie nur unvollständig, was die Qualität und Relevanz seiner Ausgabe beeinträchtigen kann. Nutzer müssen diese Grenzen kennen, um ihre Interaktionen mit dem Modell wirksam zu optimieren.
Fazit
Zusammengefasst bieten tokenbasierte Abrechnungssysteme für LLMs zwar eine strukturierte Art der Abrechnung, bringen aber auch Probleme mit sich: komplizierte Preise, unterschiedliche Tokenisierung, schwierige Budgetplanung und Grenzen bei der Eingabegröße. Für Kunden ist es entscheidend, diese Probleme zu verstehen, um sich in der Token-Ökonomie zurechtzufinden und fundiert zu entscheiden, wie sie LLM-Dienste nutzen.
Foto von Google DeepMind
Aus dem Englischen übersetzt: zum Originalbeitrag