

In der Welt der künstlichen Intelligenz (KI) sind Daten die wichtigste Zutat. Doch so wie rohe Zutaten erst zubereitet werden müssen, bevor daraus ein köstliches Essen wird, müssen auch Daten in eine bekömmliche Form gebracht werden, damit KI-Systeme und vor allem große Sprachmodelle (LLMs) sie „verdauen“ können. Hier kommen Embeddings in die Küche: die Geheimzutat, die Daten für KI erst schmackhaft macht.
Was sind Embeddings?
Embeddings sind so etwas wie der Universalübersetzer der KI. Sie nehmen die chaotische, vielfältige Welt der menschlichen Sprache und bringen sie in eine Form, die Computer verstehen und effizient verarbeiten können. Stellen Sie sich vor, Sie wollten einem Computer den Begriff „heiß“ erklären. Sie könnten Synonyme aufzählen, Temperatur beschreiben oder Beispiele nennen. Embeddings machen etwas Ähnliches, nur viel raffinierter und in Zahlen.
Im Detail: Vektordarstellung
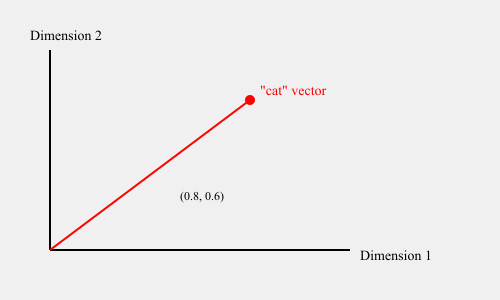
Embeddings sind letztlich Vektordarstellungen von Daten. Ein Vektor ist einfach eine Liste von Zahlen. Das Wort „Haus“ könnte zum Beispiel so aussehen:
[0.2, -0.5, 0.1, 0.8, -0.3]
Jede Zahl in diesem Vektor entspricht einer Dimension in einem mehrdimensionalen Raum. Die Werte in den einzelnen Dimensionen erfassen verschiedene Aspekte der Wortbedeutung.
Das Rezept für Embeddings
- Mit Rohdaten beginnen: Das können Wörter, Sätze oder ganze Dokumente sein. Beispiel: Nehmen wir den Satz „Die Katze saß auf der Matte.“
- Neuronale Magie anwenden: Mit cleveren Techniken aus dem Bereich der neuronalen Netze verwandeln wir jedes Datenstück in eine Liste von Zahlen (einen Vektor). Ein einfaches Word2Vec-Modell könnte unseren Satz etwa so verarbeiten:
- „Die“ → [0.1, -0.2, 0.3, …]
- „Katze“ → [0.5, 0.1, -0.3, …]
- „saß“ → [-0.2, 0.4, 0.1, …] …und so weiter.
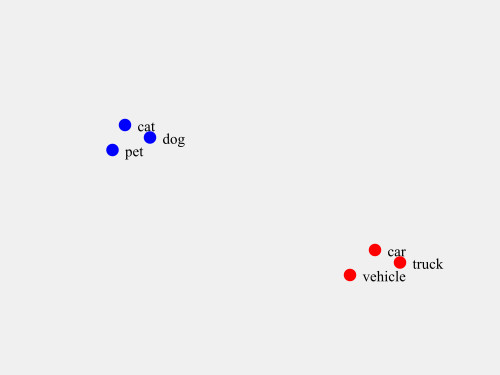
- Mit Bedeutung würzen: Diese Zahlen sind nicht zufällig. Sie sind sorgfältig so gewählt, dass sie das Wesen der ursprünglichen Daten und deren Beziehungen erfassen. In unserem Beispiel läge der Vektor für „Katze“ am Ende vielleicht näher bei den Vektoren für „Hund“ oder „Haustier“ als bei „Auto“ oder „Wolkenkratzer“.
- In einem mehrdimensionalen Raum anrichten: Diese Zahlenlisten (Vektoren) landen in einem riesigen mehrdimensionalen Raum, in dem sich Ähnliches zu Gruppen zusammenfindet.
Warum Embeddings für KI wichtig sind
- Bedeutung in Zahlen: Durch Embeddings versteht KI, dass „Hund“ dem Wort „Welpe“ näher steht als dem Wort „Logarithmus“, und zwar allein über numerische Beziehungen. Beispiel: In einem gut trainierten Embedding-Raum könnte die Kosinus-Ähnlichkeit zwischen „Hund“ und „Welpe“ bei 0,8 liegen, zwischen „Hund“ und „Logarithmus“ dagegen bei 0,1.
- Effizienz: Statt mit Millionen verschiedener Wörter zu hantieren, arbeitet KI mit kompakten Zahlenlisten. Das beschleunigt die Verarbeitung und spart Speicher. Beispiel: Ein Wortschatz von 100.000 Wörtern, jedes als Vektor mit 300 Dimensionen dargestellt, bräuchte nur etwa 120 MB Speicher.
- Verborgene Muster aufdecken: Embeddings können Zusammenhänge in Daten sichtbar machen, die menschlichen Beobachtern vielleicht nicht auffallen. Beispiel: Mit Word Embeddings wurden schon geschlechtsspezifische Vorurteile in der Sprache nachgewiesen, etwa die Verbindung von „doctor“ mit männlichen und „nurse“ mit weiblichen Begriffen.
- Sprachen verbinden: Bei der maschinellen Übersetzung helfen Embeddings, Entsprechungen in anderen Sprachen zu finden, weil Wörter mit ähnlicher Bedeutung im Embedding-Raum nahe beieinander liegen. Beispiel: Das englische Wort „dog“ und das spanische Wort „perro“ könnten in einem mehrsprachigen Embedding-Raum ähnliche Vektordarstellungen haben.
Embeddings im Einsatz
Ein paar Beispiele, wie Embeddings KI-Anwendungen würzen:
- Empfehlungssysteme: Wenn Nutzervorlieben und Artikeleigenschaften als Embeddings vorliegen, kann KI Produkte oder Inhalte vorschlagen, die Ihnen wahrscheinlich gefallen. Beispiel: Netflix stellt sowohl Nutzer als auch Filme mit Embeddings dar. Rückt Ihr Sehverlauf Sie im Embedding-Raum in die Nähe von Sci-Fi-Actionfilmen, bekommen Sie solche Filme eher empfohlen.
- Suchmaschinen: Embeddings helfen Suchmaschinen, die Absicht hinter Ihren Anfragen zu verstehen, statt nur Schlüsselwörter abzugleichen. Beispiel: Eine Suche nach „java“ könnte Ergebnisse zu Kaffee und zu Programmierung liefern, weil das Embedding für „java“ beide Bedeutungen erfasst.
- Sentiment-Analyse: Weil Embeddings feine Bedeutungsnuancen von Wörtern erfassen, erkennt KI besser, welche Gefühle ein Text ausdrückt. Beispiel: Der Satz „This movie is sick!“ könnte korrekt als positiv erkannt werden, weil das Embedding für „sick“ in diesem Kontext näher bei positiv besetzten Wörtern läge.
- Übersetzung: Embeddings sind die Grundlage moderner Übersetzungssysteme und helfen, die Bedeutung über Sprachgrenzen hinweg zu erhalten. Beispiel: Beim Übersetzen von „I love you“ ins Französische könnte das System über die Embeddings dieser Wörter den am besten passenden Ausdruck „Je t’aime“ finden, statt Wort für Wort zu übersetzen.
Die Entwicklung der Embeddings
Embeddings haben einen weiten Weg hinter sich:
- Word2Vec: Einer der Pioniere, der Wörter anhand ihres Kontexts in Vektoren verwandelt. Beispiel: Im Satz „The quick brown fox jumps over the lazy dog“ würde Word2Vec lernen, dass „fox“ und „dog“ irgendwie zusammenhängen, weil sie in ähnlichen Kontexten vorkommen.
- GloVe: Verbesserte Word2Vec, indem es globale Statistiken darüber einbezog, wie oft Wörter gemeinsam vorkommen. Beispiel: GloVe könnte bemerken, dass „Eis“ und „Dampf“ oft in ähnlichen Kontexten mit Wörtern wie „Wasser“, „fest“ und „Gas“ auftauchen, und so die Beziehung zwischen diesen Begriffen lernen.
- FastText: Erweiterte die Embeddings um Wortteile (Subwords), was bei seltenen Wörtern und Tippfehlern hilft. Beispiel: Selbst wenn es das Wort „unfriendliest“ noch nie gesehen hat, kann FastText dafür ein sinnvolles Embedding erzeugen, indem es die Embeddings von „un-“, „friend“, „-li-“ und „-est“ kombiniert.
- Kontextuelle Embeddings: Moderne Ansätze wie BERT und GPT erzeugen dynamische Embeddings, die sich je nach Kontext ändern und noch feinere Bedeutungsunterschiede erfassen. Beispiel: Bei BERT hätte das Wort „bank“ in „river bank“ und „bank account“ unterschiedliche Embeddings, entsprechend seinen verschiedenen Bedeutungen in diesen Kontexten.
Warum Embeddings für große Sprachmodelle (LLMs) so entscheidend sind
Große Sprachmodelle wie GPT-3, BERT und ihre Nachfolger wie ChatGPT, Claude, Mistral oder LLaMa haben die Verarbeitung natürlicher Sprache revolutioniert. Einen großen Teil dieses Erfolgs verdanken sie der Leistungsfähigkeit von Embeddings. Darum sind Embeddings für LLMs so wichtig:
- Effiziente Eingabedarstellung: LLMs verarbeiten enorme Mengen an Textdaten. Embeddings liefern für Wörter und Sätze eine kompakte Darstellung mit fester Größe, unabhängig von deren ursprünglicher Länge. So können LLMs Eingaben effizient verarbeiten. Beispiel: Statt mit Zeichenfolgen variabler Länge oder One-Hot-kodierten Vektoren (die bei großen Wortschätzen riesig wären) arbeiten LLMs für jedes Token mit Embedding-Vektoren fester Größe.
- Semantische Beziehungen erfassen: Embeddings kodieren Bedeutung. LLMs verstehen dadurch Beziehungen zwischen Wörtern und Begriffen, ohne dass jemand diese Beziehungen explizit programmieren muss. Beispiel: Ein LLM kann allein über die mathematischen Beziehungen in den Embedding-Vektoren verstehen, dass sich „König“ zu „Mann“ verhält wie „Königin“ zu „Frau“.
- Transfer Learning: Mit vortrainierten Embeddings starten LLMs schon vor dem aufgabenspezifischen Training mit einem guten Sprachverständnis. Diese Form von Transfer Learning verbessert die Leistung deutlich und verkürzt die Trainingszeit für neue Aufgaben. Beispiel: Ein auf allgemeinen Texten vortrainiertes Modell passt sich schnell an bestimmte Aufgaben wie Sentiment-Analyse oder Named Entity Recognition an, weil es Wortbedeutungen und Wortbeziehungen bereits kennt.
- Umgang mit unbekannten Wörtern: Fortgeschrittene Embedding-Techniken erlauben LLMs, auch für Wörter, die im Training nie vorkamen, sinnvolle Darstellungen zu erzeugen. Beispiel: Mit Subword-Tokenisierung und Embedding-Methoden, wie sie BERT nutzt, kann das Modell seltene Wörter oder sogar Tippfehler verarbeiten, indem es sie in bekannte Wortteile zerlegt.
- Kontextverständnis: Moderne LLMs nutzen kontextuelle Embeddings, bei denen sich die Darstellung eines Wortes mit dem Kontext ändert. Das ermöglicht ein viel feineres Sprachverständnis. Beispiel: In den Sätzen „I’m going to the bank to deposit money“ und „I’m going to sit on the river bank“ würde ein LLM mit kontextuellen Embeddings „bank“ unterschiedlich darstellen und so die verschiedenen Bedeutungen erfassen.
- Sprachübergreifende Fähigkeiten: Mehrsprachige Embeddings ermöglichen LLMs sprachübergreifende Aufgaben, also Texte in mehreren Sprachen zu verstehen und zu erzeugen. Beispiel: Ein mehrsprachiges LLM kann verstehen, dass „dog“ (Englisch), „perro“ (Spanisch) und „chien“ (Französisch) denselben Begriff bezeichnen, weil ihre Embedding-Darstellungen ähnlich wären.
- Unterstützung des Attention-Mechanismus: In Transformer-basierten LLMs sind Embeddings entscheidend für den Attention-Mechanismus, mit dem sich das Modell beim Erzeugen der Ausgabe auf die relevanten Teile der Eingabe konzentriert. Beispiel: Beim Übersetzen von „The man bit the dog“ ins Französische nutzt der Attention-Mechanismus Wort-Embeddings, um zu erkennen, welche Wörter für die korrekte Übersetzung jedes Satzteils am wichtigsten sind.
- Dimensionsreduktion: Embeddings reduzieren die hohe Dimensionalität von Sprachdaten, sodass LLMs überhaupt aus riesigen Textmengen lernen und sie verarbeiten können. Beispiel: Statt mit dünn besetzten Vektoren in einem Wortschatz-Raum von Hunderttausenden Dimensionen arbeiten LLMs mit dicht besetzten Embedding-Vektoren von nur wenigen hundert Dimensionen.
Kurz gesagt: Auf Embeddings baut das Sprachverständnis von LLMs auf. Sie verwandeln die komplexe, chaotische Welt der menschlichen Sprache in eine strukturierte, mathematische Form, mit der Maschinen effektiv arbeiten können. Erst diese Umwandlung ermöglicht die scheinbar magischen Leistungen von LLMs beim Verstehen und Erzeugen von Sprache.
Fazit: Die Zukunft ist eingebettet
Mit dem Fortschritt der KI entwickeln sich auch Embeddings weiter. Sie sind die heimlichen Helden, dank denen Maschinen unsere chaotische, schöne, komplexe Welt menschlicher Kommunikation erfassen können. Indem sie Daten in eine Form bringen, die KIs effizient verarbeiten können, ebnen Embeddings den Weg für intelligentere, differenziertere und hilfreichere KI-Systeme.
Wenn Sie das nächste Mal staunen, wie gut eine KI menschenähnlichen Text versteht oder erzeugt, denken Sie an das bescheidene Embedding: die Geheimzutat, die all das erst möglich macht.
Aus dem Englischen übersetzt: zum Originalbeitrag