
Im April 2026 stellte das Forecasting Research Institute seinem Expertenpanel eine einfache Frage. Wie lang ist bis Jahresende die längste Aufgabe, die ein KI-Modell mit 80 % Zuverlässigkeit erledigt, gemessen an METRs Time-Horizon-Maß? Der Median der Experten lag bei 3,4 Stunden. Der Median der Superforecaster bei 3,5.
Am 8. Mai, als die Umfrage noch lief, veröffentlichte METR seine Schätzung für einen frühen Snapshot von Anthropics nicht öffentlich zugänglichem Preview-Modell: 3,1 Stunden. Die Prognose für Dezember war fast erreicht, bevor das letzte Panelmitglied seine abgegeben hatte.

Dieses Detail steckt in der ersten Überprüfung der eigenen KI-Prognosen durch das FRI, veröffentlicht am 22. September. Sie umfasst vier Jahre und sieben Studien, und nur wenige öffentliche Aufzeichnungen bewerten fundierte Vorhersagen zu dieser Technologie so systematisch. Es handelt sich um einen redaktionellen Beitrag, kein peer-reviewtes Paper, und die Zahlen unten stammen vom FRI selbst, bewertet nach den eigenen Auflösungskriterien des FRI. Das Hauptergebnis ist das, was alle vermutet hatten: Experten und Superforecaster unterschätzen den Fortschritt der KI dramatisch. Lesenswert machen den Bericht die paar Stellen, an denen sie das nicht tun.
Benchmarks schlagen die Prognosen um Jahre
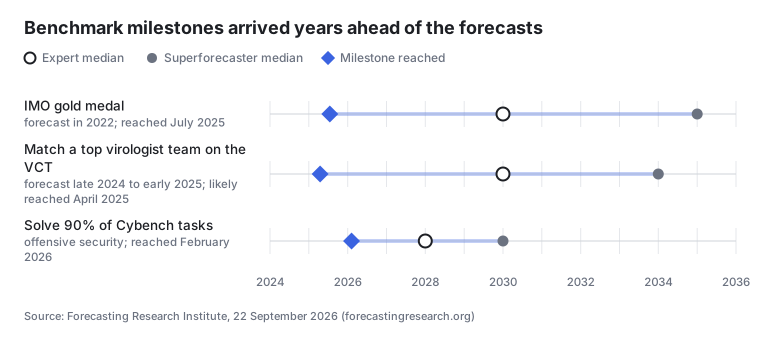
Das Existential Risk Persuasion Tournament des FRI lief Mitte 2022, in den Monaten bevor ChatGPT öffentlich wurde, und fragte nach Prognosen zu vier Benchmarks: MATH, MMLU, QuALITY und die Internationale Mathematik-Olympiade. Gemittelt über alle vier hatten die Superforecaster dem, was dann tatsächlich passierte, eine Wahrscheinlichkeit von 9,7 % gegeben. Die Fachexperten 24,6 %. KI holte im Juli 2025 IMO-Gold, fünf Jahre vor dem Median der Experten und ein Jahrzehnt vor dem der Superforecaster.
Die naheliegende Verteidigung ist das Timing. Mitte 2022 hatten nur wenige Menschen ein Chatmodell benutzt, also lagen sie natürlich daneben. Nur: Die Fehlschätzungen gingen weiter, lange nachdem alle eines benutzt hatten.
Zwischen November 2024 und Februar 2025 fragte das FRI Fachleute aus Biologie und Biosicherheit, wann KI beim Virology Capabilities Test mit einem Spitzenteam von Virologen gleichziehen würde. Die Experten sagten 2030. Die Superforecaster 2034. Nach Einschätzung des FRI waren die Modelle wahrscheinlich im April 2025 so weit, wenige Monate nach Ende der Umfrage. Bei Cybench, einem Capture-the-Flag-Benchmark für offensive Sicherheit, lagen die Mediane für das Lösen von 90 % der Aufgaben bei 2028 und 2030. Die Schwelle fiel im Februar 2026.
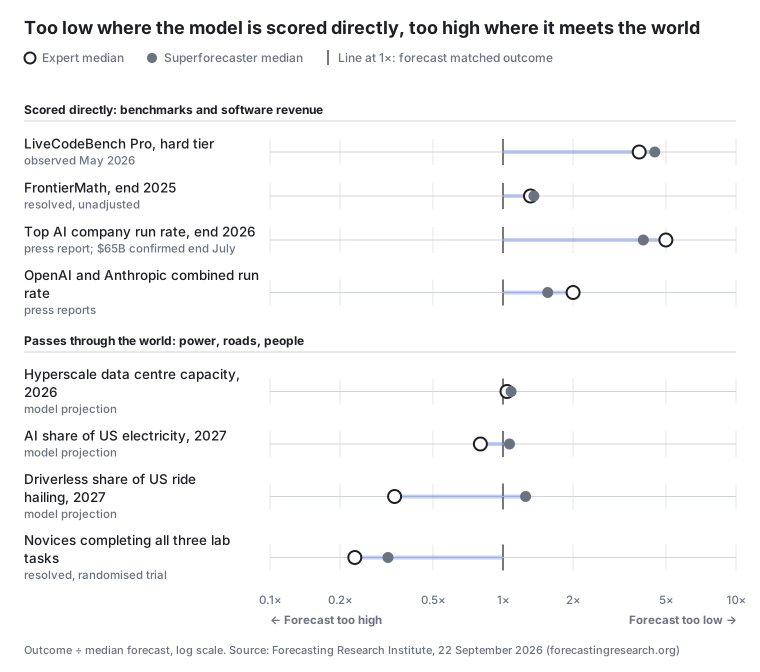
Das 2025 gestartete Expertenpanel schnitt nicht besser ab. Im Sommer 2025 nach dem besten FrontierMath-Ergebnis bis Jahresende gefragt, sagten beide Gruppen etwa 30 %; aufgelöst wurde die Frage bei 40,7 %, eine Zahl, die das FRI unbereinigt angibt, weil Epoch später Fehler in einem großen Teil der Aufgaben fand. Die Richtung übersteht jede Korrektur. Für den schweren Teil von LiveCodeBench Pro sahen Ende 2025 gesammelte Prognosen den State of the Art bis Ende 2026 bei 12 bis 14 %. Im Mai 2026 lag er bei 53,8 %. Das sind aufgelöste Fragen oder beobachtete Werte und damit die stärksten Belege im Bericht. Es sind aber auch durchwegs Benchmarks, bei denen ein Modell gegen einen Lösungsschlüssel bewertet wird.
Der Umsatz folgt der Benchmark-Kurve
Eine Kennzahl zur Verbreitung folgt derselben Kurve. In der Studie des FRI zu den wirtschaftlichen Auswirkungen von KI sollten die Teilnehmer den höchsten jährlich wiederkehrenden Umsatz eines KI-Unternehmens Ende 2026 prognostizieren. KI-Experten sagten 20 Milliarden Dollar. Ökonomen 16 Milliarden. Superforecaster 25 Milliarden. Das FRI beziffert den aktuellen Wert mit rund 100 Milliarden Dollar und beruft sich dabei auf einen Pressebericht, der einen Artikel der New York Times über Anthropics Run Rate wiedergibt; Bloombergs Darstellung derselben Geschichte beschreibt 100 Milliarden Dollar als den Wert, bei dem das Jahr enden wird, nicht als das aktuelle Tempo. Die letzte direkt berichtete Zahl, 65 Milliarden Dollar Ende Juli, liegt bereits mehr als zweieinhalbmal über der höchsten Prognose. Stimmt der neuere Bericht, beträgt die Lücke den Faktor vier.
Im Sommer 2026 bekam das Panel eine schärfere Version der Frage: die kombinierte Run Rate von OpenAI und Anthropic zum Jahresende. Die Experten sagten 70 Milliarden Dollar, die Superforecaster 90 Milliarden. Der wahrscheinliche aktuelle Wert laut FRI, wieder aus Presseberichten, liegt bei etwa 140 Milliarden. Schon mit den bis Mitte August berichteten Zahlen, 65 Milliarden für Anthropic und 40 Milliarden für OpenAI, lag die Summe über 100 Milliarden.
Als beide Gruppen diese Zahlen abgaben, so das FRI in einer Fußnote, lagen ihre Mediane bereits unter den zuletzt veröffentlichten Umsatzzahlen, die damals öffentlich zugänglich waren. Das FRI vermutet, dass die eigene Oberfläche es leicht machte, sich an älteren Zahlen zu orientieren, und merkt an, dass die schriftlichen Begründungen der Superforecaster weniger Anzeichen dieses Ausrutschers zeigen. So oder so hinkte die Prognose der Realität schon am Tag ihrer Abgabe hinterher.
Neue Überzeugungen machten die Prognosen nicht besser
Die naheliegende Reaktion auf vier Jahre Unterschätzung ist, die eigenen Annahmen anzupassen, und das Panel hat das getan. Im Sommer 2025 und erneut im Frühjahr 2026 fragte das FRI, wo KI bis 2040 auf Nate Silvers Technological Richter Scale stehen würde. In diesen neun Monaten verschoben dieselben Panelmitglieder Wahrscheinlichkeit in Richtung Stufe 9, also einer Technologie des Jahrtausends auf einer Ebene mit der Landwirtschaft, gaben den größten Anteil aber weiterhin Stufe 8, neben der Elektrizität.
Ihre Überzeugungen bewegten sich, ihre Prognosen wurden aber nicht besser. Die METR-Frage wurde im April 2026 gestellt, die Umsatzfrage im Sommer, und beide steuern auf eine Unterschätzung zu. Das FRI hält unmissverständlich fest, dass es bei den neueren Fragen keinen Zugewinn an Genauigkeit sieht.
Genau das macht ein exponentieller Verlauf mit jemandem, der vom letzten bekannten Punkt aus extrapoliert. Die Methode ist vernünftig. Sie scheitert, wenn sich die Größe schneller verdoppelt, als die Zeit zwischen Frage und Auflösung vergeht, weil der letzte bekannte Punkt schon veraltet ist, wenn die Antwort aufgeschrieben wird. Allgemein an schnellen Fortschritt zu glauben, behebt das nicht, denn der Fehler passiert in dem Moment, in dem eine konkrete Zahl notiert wird.
Wo KI auf die Welt trifft, hielten die Prognosen
Wäre das schon der ganze Bericht, ginge es um Menschen, die exponentielles Wachstum falsch einschätzen. Der Rest der Daten zeichnet aber ein komplizierteres (und interessanteres) Bild.
Beim Anteil von KI am US-Stromverbrauch und bei der installierten Kapazität von Hyperscale-Rechenzentren liegen die Mediane des Panels nahe an den Projektionen. Die Experten sagten für 2026 50 Gigawatt Hyperscale-Kapazität, die Superforecaster 48, projiziert sind 52. Für 2027 schätzten die Experten den Anteil der KI am US-Strom auf 4 %, die Superforecaster auf 3 %, projiziert sind 3,2 %. Diese Projektionen stammen von einem OpenAI-Reasoning-Modell der Spitzenklasse, das das FRI im August 2026 laufen ließ, Monate nachdem die Menschen geantwortet hatten. Es sind Projektionen, keine Auflösungen, und das Modell hatte mehr Daten zur Verfügung.
Bei autonomen Fahrzeugen schossen die Experten übers Ziel hinaus. Mitte 2025 gefragt, welcher Anteil der Ride-Hailing-Fahrten in den USA im Jahr 2027 fahrerlos sein würde, nannte der Median der Experten 7,3 %. Die Projektion sagt 2,5 %. Die Superforecaster sagten 2 %.
Und im Fall mit den saubersten Daten lagen alle zu hoch. Mitte 2025 fragte das FRI, welcher Anteil von Bachelorstudierenden in MINT-Fächern mit einem LLM drei für Biorisiken relevante Laboraufgaben in einer von Active Site durchgeführten randomisierten kontrollierten Studie bewältigen könnte. Biosicherheitsexperten sagten 22,5 %. Virologen 40 %. Superforecaster 16,2 %. In der Studie schafften 5,2 % alle drei Aufgaben.
Sortiert man die Fragen danach, in welche Richtung die Prognosen danebenlagen, zerfallen sie in zwei Gruppen. Die Unterschätzungen häufen sich dort, wo der Fortschritt durch Rechenleistung und Überprüfbarkeit begrenzt ist: bei Benchmarks, wo ein Modell gegen einen Lösungsschlüssel bewertet wird, und beim Umsatz aus API-Aufrufen und Abos, also dort, wo Software auf Software trifft und wenig dazwischen liegt. Die treffenden Prognosen und die Überschätzungen häufen sich dort, wo der Fortschritt durch etwas hindurch muss, das nicht mit Rechenleistung skaliert. Rechenzentren brauchen Netzanschlüsse und Genehmigungen, fahrerlose Autos brauchen gefahrene Meilen auf echten Straßen und Regulierungsbehörden, und die Studie brauchte Studierende, die die Arbeit am Labortisch erledigen.
Die Ergebnisse aus der Biologie zeigen diese Nahtstelle ungewöhnlich präzise, weil das FRI beide Seiten gemessen hat. Bis April 2025 zogen Modelle wahrscheinlich mit einem Spitzenteam von Virologen gleich, wenn es um die Fehlersuche in Laborprotokollen ging. Mitte 2025 brachten Modelle dieser Generation nur 5,2 % der Laien durch alle drei realen Aufgaben. Das Wissen steckte im Modell, aber über einen Laien kam nur wenig davon am Labortisch an.
Das FRI bietet noch eine andere Lesart an. Vielleicht bewegten sich die Benchmarks so schnell, weil man leichter auf sie hintrainieren konnte, als irgendwer erwartet hatte, und ein Benchmark-Ergebnis sagt einfach wenig über die Welt aus. Für manche Benchmarks mag das stimmen. Die Nahtstelle verschwindet dadurch nicht. Ob nun der VCT-Wert überzeichnet, was das Modell weiß, oder die Studie unterschätzt, was eine geschulte Fachkraft herausholen könnte: Die Lücke liegt an derselben Stelle, zwischen dem, was ein Modell bei direkter Bewertung leistet, und dem, was es liefert, sobald ein Mensch, ein Fahrzeug oder ein Stromnetz zwischen ihm und dem Ergebnis steht. Der Umsatz spricht ohnehin gegen die reine Erklärung, man habe nur auf den Test hintrainiert. Niemand zahlt jedes Jahr zig Milliarden für einen Platz auf einer Rangliste.
Bauen Sie für zwei Uhren
Für alle, die Agent-Systeme bauen, ist das der praktischste Punkt im Bericht. Ein Agent ist ein Modell in einer Schleife, und die Schleife greift nach draußen: zu einer prüfenden Person, einer Freigabe-Warteschlange, einem Zahlungssystem, einer Maschine in der Fertigungshalle. Die beiden Seiten dieser Grenze laufen nach unterschiedlichen Uhren, und die Daten legen nahe, für beide zu planen.
- Spezifizieren Sie für das Modell, mit dem Sie ausliefern werden. Die Prognosen zu den Fähigkeiten der Modelle, abgegeben von den bestinformierten Leuten, die es gibt, lagen um Jahre hinter der Entwicklung zurück. Halten Sie den Harness also so schlank, dass ein stärkeres Modell ohne Neuschreiben hineinpasst.
- Planen Sie die Ränder nach der langsamen Uhr. Menschliche Prüfung, Freigaben, Integrationen mit physischen Systemen und unerfahrene Bediener bestimmen das Tempo des tatsächlich gelieferten Nutzens, und ein schnelleres Modell ändert daran nichts.
- Messen Sie, was auf der anderen Seite des Bedieners herauskommt. Die Studie zeigt, dass die gelieferte Fähigkeit weit unter dem liegen kann, was ein Benchmark nahelegt, und dass ausgerechnet die Leute, die das Fachgebiet am besten kennen, zu hoch schätzen.
Der nächste Prognostiker läuft nach der schnellen Uhr
Nichts davon ist entschieden, und das FRI sagt das deutlicher als die meisten. Seine Methode begünstigt das Aufdecken von Unterschätzungen: Eine zu niedrige Prognose fliegt auf, sobald die Realität sie überholt, eine zu hohe lässt sich erst bestätigen, wenn ihr Auflösungsdatum verstrichen ist. Die meisten Fragen sind noch nicht aufgelöst. Außerdem arbeitet das FRI mit Medianen, und die verdecken jene Teilgruppen von Prognostikern, die deutlich besser lagen. Die Überschätzungen zeigen sich vielleicht erst 2030, und die wichtigsten Fragen, zu Wachstum, Arbeit, Ungleichheit und katastrophalen Risiken, werden als letzte aufgelöst.
Wo Fragen noch offen waren, bewertete das FRI die Menschen anhand der Projektionen eines Modells und weist offen darauf hin, dass das Modell Monate an Rückschau hatte. ForecastBench zeigt bereits, dass manche Modelle bei manchen Fragetypen auf dem Niveau von Superforecastern prognostizieren, und als nächsten Schritt will das FRI laufend aktualisierte LLM-Prognosen direkt ins Panel aufnehmen. Die Logik stimmt: Wenn Menschen mit der Kurve nicht Schritt halten, nimmt man etwas, das sie in Echtzeit liest.
Nur lebt der neue Prognostiker auf der schnellen Seite der Nahtstelle, und die Fragen, die man ihm stellen wird, liegen auf der langsamen. Die Experten, die bei Benchmarks um Jahre danebenlagen, irrten sich bei autonomen Fahrzeugen in die andere Richtung. Welchen dieser Fehler die Maschine machen wird, weiß noch niemand.
Aus dem Englischen übersetzt: zum Originalbeitrag